Data lakes: wat zijn het en hoe gebruik je ze?
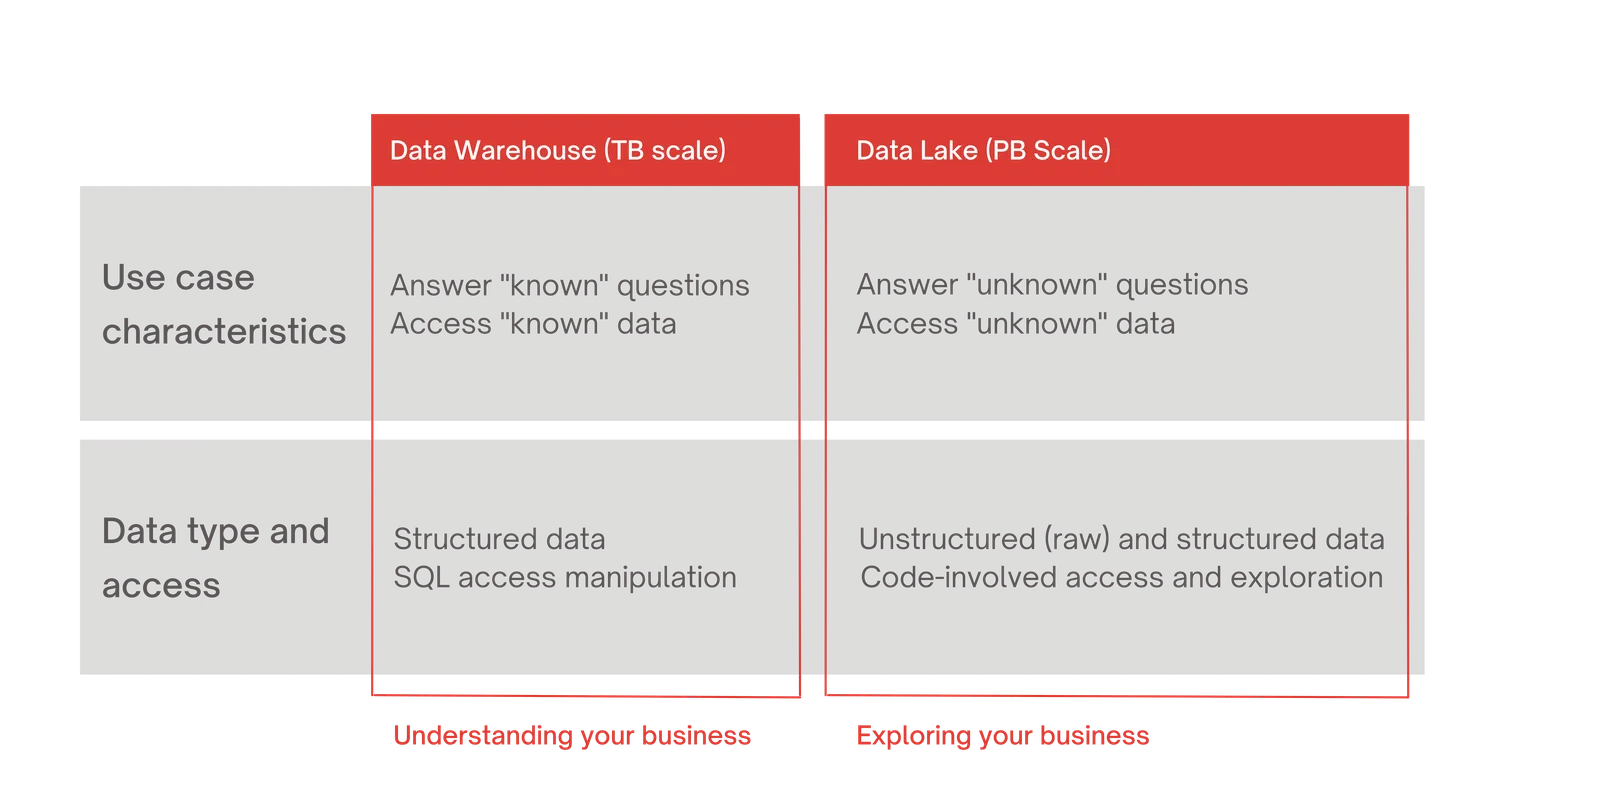
Data lakes en data warehouses worden allebei gebruikt om big data op te slaan, maar de termen zijn niet uitwisselbaar. Eigenlijk is dat ook de enige overeenkomst: in beide sla je data op. Het doel is anders.
Voor sommige bedrijven past een data warehouse beter, voor andere is een data lake de betere oplossing, en soms werkt een hybride opzet het best. In dit artikel leg ik uit wat een data lake is en hoe het verschilt van een data warehouse. Ik ga in op de architectuur van een data lake en op de best practices en use cases.
Wat is een data lake?
Zoals een meer bestaat uit vrij stromende watermoleculen, bestaat een data lake uit ruwe, vrij stromende data. Een data lake is een grote opslagplaats die ruwe data in het oorspronkelijke formaat bewaart. Dat ongestructureerde karakter is ook een van de belangrijkste verschillen met een data warehouse, dat data opslaat die al verwerkt is. De data in een data lake ligt klaar tot ze nodig is voor analyse.
Een data lake slaat data op in een platte architectuur. Er wordt vooral gewerkt met bestanden en objectopslag. Er is geen schema vastgelegd tot de data wordt bevraagd. Elk stukje informatie heeft een unieke identifier en krijgt een set metadatatags. Je kunt een data lake bevragen op relevante data. Die kleinere set data kun je dan analyseren om bedrijfsvragen te beantwoorden.
Waarom zou je een data lake gebruiken?
Veel data lakes, speciaal ontworpen voor klantdatabeheer, bevatten grote sets gestructureerde, ongestructureerde en semigestructureerde data. Zulke omgevingen kun je niet met een relationele database gebruiken, omdat zo'n systeem een vast schema voor de data vereist. Daardoor kan het alleen gestructureerde data opslaan.
De meeste data warehouses zijn gebouwd op relationele databases en staan geen verschillende schema's toe. Data lakes kunnen dat juist wel, en ze vereisen vooraf geen vastgelegd schema. Daardoor zijn ze zo sterk in het verwerken van verschillende soorten data in verschillende formaten.
Voor veel organisaties maakt dat data lakes tot een belangrijk onderdeel van hun data-architectuur. De meeste bedrijven gebruiken ze als platform voor big-data-analyse en datascience-toepassingen met geavanceerde analysemethoden, zoals datamining, machine learning en voorspellende analyse.
Schema-on-read en schema-on-write in data lakes
Data lakes hebben geen schema nodig. Wil een gebruiker de data bekijken, dan kan hij op dat moment een schema toepassen. Dat heet schema-on-read. Ik vind dat een groot voordeel van data lakes.
Voor bedrijven die regelmatig nieuwe databronnen toevoegen, is dat bijzonder handig. Een schema vooraf vastleggen kost veel tijd, dus dat je geen schema hoeft te ontwerpen, is een groot voordeel van data lakes.
Een data warehouse heeft een vooraf vastgelegd schema: het schema is ontworpen voordat de data in het warehouse wordt geladen. Dat heet schema-on-write. Dat kan verhinderen dat data die niet aan het schema voldoet, wordt ingevoegd.
Een data warehouse past daarom beter wanneer een bedrijf een grote hoeveelheid repetitieve data heeft die geanalyseerd moet worden voor vooraf vastgestelde bedrijfsvragen.
Lakehouse
De hoeveelheid big data groeit elke dag.
Volgens Gartner bevat in 2022 90% van de bedrijfsstrategieën analytics als essentiële competentie. Daarom moeten veel bedrijfsleiders hun strategie voor het opslaan en verwerken van data heroverwegen. Veel van die bedrijven hebben bestaande data warehouses die flexibele dataopslag bieden, maar tekortschieten als het gaat om het bewerken van data voor analyse.
De oplossing is een aanvullend data lake toevoegen aan de bestaande architectuur.
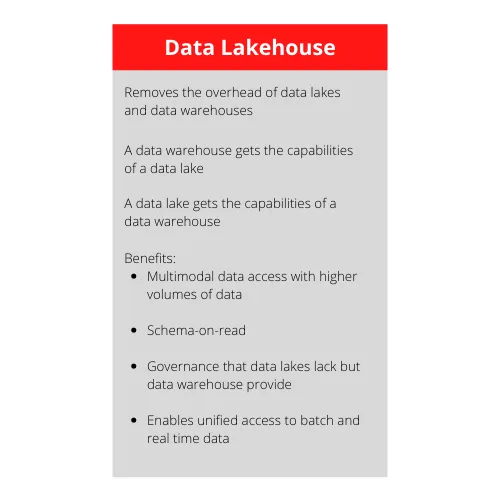
Zo'n hybride opzet heet een lakehouse. Daarmee kun je gelijktijdige workloads draaien op dezelfde datasets en de beschikbare data voor verschillende doelen hergebruiken.
Bij Crystalloids zien we de voordelen van lakehouse-oplossingen ook bij een aantal van onze klanten. Met de dubbele implementatie kun je gevoelige data naar het data warehouse leiden en buiten het data lake houden.
Dat geeft meer controle over het gebruik van data en over compliance dan wanneer je alleen een data lake gebruikt. Een lakehouse is een goede manier om data zo te beheren dat ze aan veel verschillende behoeften voldoet.
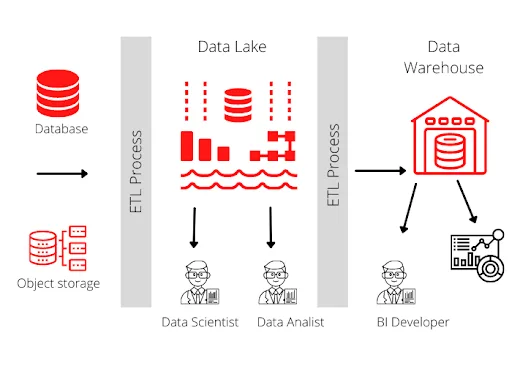
Hoe de architectuur van een data lake eruit moet zien
De juiste architectuur voor je data lake is heel belangrijk om waarde uit data te halen. De data in je data lake heb je niets aan als de architectuur niet de functies heeft om die data goed te beheren. Daarom is het belangrijk om de juiste functies vanaf het begin in de architectuur in te bouwen.
Een architectuur die op de cloud is afgestemd, maakt het data lake eenvoudiger. Een modern data lake in de cloud moet deze kenmerken hebben:
- Een architectuur met meerdere clusters en gedeelde data
- Opslag en rekenkracht die onafhankelijk van elkaar schalen
- Een goed gedefinieerde metadataservice, die de basis vormt van een omgeving met objectopslag
- Alle onderdelen van de architectuur en hun onderlinge samenwerking ondersteunen native datatypes
- Het vinden, opslaan, transformeren en visualiseren van data wordt onafhankelijk van elkaar beheerd.
- De architectuur is afgestemd op de branche, met de specifieke functies en mogelijkheden die dat domein vraagt.
Functies die in elk data lake beschikbaar moeten zijn:
Data governance: de processen en standaarden die ervoor zorgen dat de data haar beoogde doel kan dienen. Het helpt om de datakwaliteit en de databeveiliging te verbeteren. Een voorbeeld van data governance is de bestandsgrootte beperken om bestanden te standaardiseren. Te grote bestanden maken het lastig om met de data te werken. Een voorbeeld om de datakwaliteit te verbeteren is de data scannen op onvolledige of onleesbare gegevens.
Datacatalogus: de informatie over de data die in het data lake staat. Met een datacatalogus begrijp je makkelijk de context van de data. Stakeholders kunnen er sneller mee werken. Welke informatie in een datacatalogus staat, verschilt per use case, maar meestal gaat het om informatie zoals:
- De connectors die nodig zijn om met de data te werken
- Metadata over de herkomst van de data en hoe lang ze al is opgeslagen
- Een beschrijving van de applicaties die de data gebruiken
Zoeken: goed kunnen zoeken in het data lake is cruciaal. De zoekfunctie maakt het mogelijk om data te vinden op kenmerken zoals grootte, inhoud en datum van herkomst. Een best practice is een index van data-assets bouwen, zodat zoeken snel gaat.
Beveiliging: om gevoelige data privé te houden, zijn beveiligingsmaatregelen nodig, zoals toegangscontrole die voorkomt dat onbevoegden data inzien en wijzigen, en versleuteling.
Use cases voor data lakes
Hoe meer ongestructureerde data een organisatie heeft, hoe groter de behoefte aan een data lake. Een goed voorbeeld van een branche waar een data lake goed tot zijn recht komt, is de zorg.
Veel data in de zorg is ongestructureerd, denk aan:
- röntgenfoto's
- MRI-scans
- klinische data
- informatie over medicijnen
- analyses
Dat ongestructureerde karakter en de behoefte aan realtime inzichten maken data lakes geschikt voor de zorg, omdat je er gestructureerde en ongestructureerde data in kunt combineren.
In transport kunnen data lakes helpen om voorspellingen te doen. Die voorspellende mogelijkheden kunnen grote kostenbesparingen opleveren, vooral in supply chain management.
Hoe Crystalloids data lakes gebruikt voor een lakehouse
Een lakehouse bouwen is vaak onderdeel van ons werk wanneer we dataplatforms ontwikkelen, zoals Customer Data Platforms.
Een Customer Data Platform heeft als doel data uit verschillende bronnen te centraliseren. Samen kan die data nuttige inzichten geven voor allerlei doelen. Binnen een Customer Data Platform gebruik je een lakehouse om waardevolle inzichten in klantgedrag te krijgen en klantactivaties te automatiseren in owned, paid en earned kanalen.
Een voorbeeld: op het centrale datapunt ontstaat een klantprofiel op basis van data zoals aankoopgedrag en loyaliteit, die uit verschillende systemen komt. Staat die data in een klantenservice-applicatie, dan kan een verkoopmedewerker zien hoe hij een bepaald type klant het beste benadert.
Om zulke profielen te maken, is het belangrijk om de historie vast te leggen. Dat gebeurt in een data lake. Andere informatie die aan het profiel bijdraagt, kan uit het data warehouse komen.
Zowel streaming data als batchdata wordt verwerkt. Komt er streaming data binnen, dan wordt die realtime weggeschreven naar de verschillende databases die de informatie nodig hebben.
Conclusie
Welke oplossing het best past bij je organisatie, hangt sterk af van de use case, het soort data en de bestaande architectuur. Heb je nog geen duidelijk doel voor je data en heeft je organisatie veel gestructureerde en ongestructureerde informatie die later gebruikt moet worden, dan is een data lake een goede oplossing.
Heeft je bedrijf een bestaand warehouse dat tekortschiet in het bewerken van data, dan is een data lake toevoegen aan de bestaande architectuur de juiste weg. Dan spreken we van een lakehouse. Daarmee kun je gelijktijdige workloads draaien op dezelfde datasets en de data voor verschillende doelen hergebruiken.
Een data warehouse past het best wanneer een bedrijf grote hoeveelheden repetitieve data en vooraf vastgestelde bedrijfsvragen heeft.
Kevin Kriek
Kevin is Head of Sales bij Crystalloids. Hij combineert diepgaande technische kennis met commercieel leiderschap om organisaties te helpen Google Cloud-oplossingen met impact te ontwerpen en te implementeren.
Bekijk alle artikelen