Wat is Data Vault-modellering? (En wanneer gebruik je het?)
In marketinganalytics, waar inzichten ontstaan door data uit verschillende bronnen samen te voegen, valt één aanpak op: Data Vault-modellering.
Veel bedrijven bewerken data via een ETL-proces (Extract, Transform en Load) en slaan die op in data warehouses voor verdere analyse. Er zijn meerdere manieren om data zo te beheren dat ze besluitvorming op basis van data en inzichten ondersteunt.
Een van de recentere benaderingen van databeheer is Data Vault-modellering (DVM). Data engineers krijgen met dit datamodel een gestructureerd kader om wendbare en robuuste data-architecturen te ontwerpen, te bouwen en te onderhouden. Data scientists hebben er op hun beurt een stevige basis aan om complexe datasets te verkennen, te analyseren en er bruikbare inzichten uit te halen.
De methode is een goed schaalbare oplossing om data uit verschillende operationele systemen langdurig, met de volledige historie, op te slaan. Welke problemen moet de Data Vault-methode dan oplossen, en in welke situaties is een Data Vault-architectuur de beste keuze? We kijken wat dieper naar de Data Vault-methodiek en naar hoe die van data iets waardevols maakt voor wie beslissingen neemt.
Welk probleem lost Data Vault-modellering op?
Voordat we die vraag beantwoorden, kijken we eerst naar andere gangbare architecturen voor een data warehouse.
Een klassieke manier om data te beheren is dimensioneel ontwerpen. Deze architectuur is erop gericht data te verwerken en resultaten snel bij eindgebruikers te krijgen. Maar nieuwe data efficiënt verwerken is met deze aanpak niet altijd makkelijk, en het bouwen van data marts kost vaak veel werk, omdat het datamodel daarvoor omgebouwd moet worden. Data Vault-modellering, geïntroduceerd door Dan Linstedt, is een alternatief dat deze problemen aanpakt, en daarmee een sterke keuze voor data warehousing en data science.
Dimensioneel modelleren (DM)
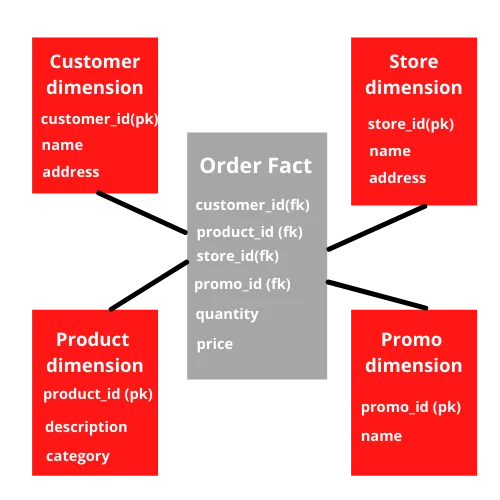
DM heeft als doel de database zo in te richten dat data sneller op te vragen is. Dimensionele datamodellen werken met dimensietabellen en feitentabellen (Dimension en Fact tables).
Neem een e-commerce use case waarin een bedrijf met grote hoeveelheden data meerdere producten en winkels heeft. Dimensietabellen kunnen dan Product, Customer, Store enzovoort zijn. Dimensies hebben een unieke identifier en daarnaast andere attributen.
Voor de dimensie Customer kan de unieke identifier, ook wel de primaire sleutel (primary key) genoemd, customer_id zijn, en kunnen de attributen naam, achternaam, e-mailadres, adres enzovoort zijn. Feitentabellen zijn tabellen zoals orderdetails, metrics en transacties uit verschillende bedrijfsprocessen, met een relatie via een vreemde sleutel (foreign key) naar een of meer dimensietabellen. Een voorbeeld van een feit in deze use case is de ordertabel.
Met een sterschema (star schema) maak je vervolgens een geaggregeerd overzicht of rapport voor een bepaalde vraag uit de business. Hieronder zie je een voorbeeld van een sterschema voor de e-commerce use case.
Nadelen van dimensioneel modelleren
Het probleem van DM is dat deze manier van modelleren vaak niet flexibel en wendbaar genoeg is als het bedrijf groeit. Dat merk je bijvoorbeeld zodra de business informatie op een ander detailniveau (grain) nodig heeft.
Neem een overzicht van de verkopen in een bepaalde stad. Je kunt een extra attribuut aan de bestaande feitentabel toevoegen, maar dan ontstaat het risico op inconsistente data, of raak je mogelijk je historie kwijt. Een andere optie is een nieuwe feitentabel met bijna dezelfde informatie, maar op een ander detailniveau. Dat maakt het model complexer en zorgt ervoor dat een sterschema sterk op één bepaalde weergave gericht is, waardoor het minder flexibel wordt.
Daarom speelt DM niet altijd goed in op veranderende behoeften van de business. Zoek je een flexibelere oplossing, dan komt de Data Vault-architectuur in beeld.
Data Vault-modellering
DVM vormt de ruggengraat van een data warehouse en is een strategische aanpak voor data-integratie. Deze moderne Data Vault-methodiek gebruikt flexibele modelleerpatronen die ruwe data integreren op basis van business keys. Doordat structurele informatie gescheiden is van beschrijvende attributen, is het datamodel veel beter bestand tegen veranderende behoeften van de business.
Een belangrijk voordeel is dat het parallel laden mogelijk maakt, zodat grote implementaties kunnen opschalen zonder dat het model op de schop moet. In de kern bevat DVM databronnen uit verschillende kanalen, en dat maakt het een veelzijdige oplossing die zich goed laat aanpassen.
Bij het beheren en benutten van data kunnen organisaties veel voordeel hebben van een Customer Data Platform (CDP). Een CDP is sterk in het integreren van data uit uiteenlopende bronnen, en zorgt voor datakwaliteit en consistentie. Door de aanpasbaarheid en schaalbaarheid van DVM te combineren met een CDP, leggen organisaties een stevige basis voor datagedreven besluitvorming.
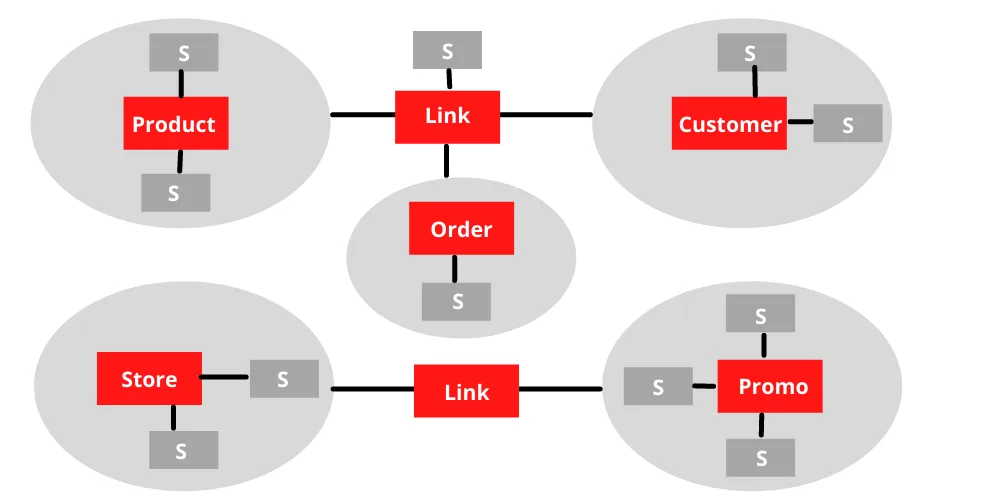
Een Data Vault-aanpak bestaat uit drie onderdelen: hubs, satellites en links. Samen vormen ze een complete taal waarmee je beschrijft hoe het bedrijf dat je analyseert in elkaar zit.
Een Data Vault-ontwerp bestaat uit:
- Hubs
- Satellites
- Links.
Hubs
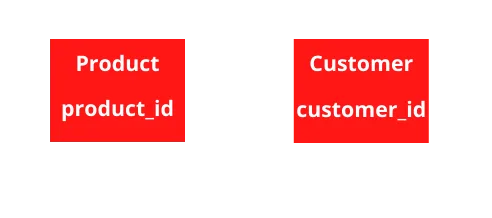
Een hub is een entiteit die betekenis heeft voor het bedrijf. Hij bevat alleen een unieke identifier die direct aan het bedrijf te relateren is. In ons voorbeeld zijn de hubs dus Product, Customer, Store en Promo, met hun unieke identifiers product_id en customer_id.
Links
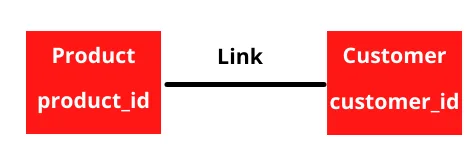
Links geven aan dat twee hubs met elkaar verbonden zijn. Het zijn relaties tussen primaire en vreemde sleutels (primary/foreign key), en ze beschrijven een unieke relatie tussen twee hubs.
 Satellites
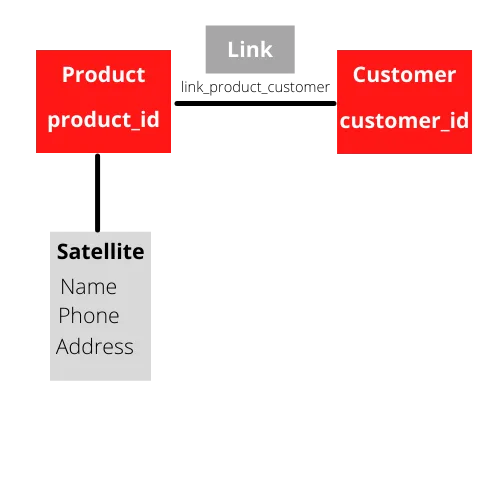
 leggen "point in time"-waarden vast: de waarde zoals die op een bepaald moment was. Je kunt ze vergelijken met de attributen in een dimensietabel. Ze zijn gekoppeld aan hub- of linktabellen, maar niet aan andere satellites. Een satellite hoort bij maar één hub. De historie bewaren ze als nieuwe records: bij elke wijziging van een waarde wordt een nieuw satellite-record met een tijdstempel opgeslagen.
In een Data Vault wordt dus nooit iets verwijderd of bijgewerkt, alleen toegevoegd. Daardoor kun je de vraag beantwoorden: "Wat wisten we wanneer?"
 Een vereenvoudigd overzicht van een Data Vault-model ziet er zo uit:
Use cases voor Data Vault (DV)
Hoe past een Data Vault zich aan als de behoeften van de business veranderen? Stel dat een Store opeens belastinggegevens nodig heeft, data die mogelijk uit een ander systeem komt.
Een DV vangt die wijziging op door een extra satellite toe te voegen voor de belastinggegevens, zonder dat de bestaande datastructuur verandert. Die flexibiliteit zorgt voor schaalbaarheid, aanpasbaarheid en consistente data, en sluit goed aan bij de werkwijze in data warehousing.
Deze hybride modelleertechniek combineert de sterke punten van de aanpak van het data warehouse en het data lake. Toch is ze niet geschikt voor elk soort rapportage of elke use case.
Hieronder vijf use cases voor Data Vault, die laten zien waarom het een best practice is voor efficiënt databeheer:
- Dynamische bedrijfsomgevingen: In sectoren die snel veranderen, kan traditioneel databeheer veranderende structuren moeilijk bijhouden. DV is sterk in zulke dynamische omgevingen: organisaties kunnen zich aanpassen en nieuwe databehoeften opvangen.
- Historische data bewaren: Als historische data belangrijk is, valt DV op. Het legt wijzigingen nauwkeurig vast door het laadmoment onderdeel te maken van de primaire sleutel, zodat er een uitgebreide historie ontstaat. Daarmee is het een voor de hand liggende keuze voor bedrijven die volledige historische data nodig hebben voor analyse en compliance.
- Schaalbare oplossingen: Met een Data Vault groei je mee met je data zonder dat het model steeds opnieuw ontworpen moet worden. Als de datavolumes groeien, verwerkt DV de belasting efficiënt, en daarmee is het een best practice voor organisaties die meer met hun data willen kunnen.
- Data-integratie over uiteenlopende bronnen: DV is een stevige oplossing om data uit verschillende bronnen te integreren, ook gestructureerde en ongestructureerde data, met behoud van consistentie en kwaliteit. Het is vooral waardevol als data uit systemen komt die los van elkaar staan.
- Efficiënte data warehousing: DV maakt het mogelijk data efficiënt in data warehouses te laden. Omdat veel tabellen parallel geladen kunnen worden, werken datapipelines efficiënter en verloopt het binnenhalen, opslaan en ontsluiten van data vlotter. Daarmee is het een best practice voor data warehousing.
In al deze use cases blijkt DV een veelzijdige en effectieve aanpak voor organisaties die hun databeheer willen verbeteren.
Wanneer gebruik je geen Data Vault?
Overweeg je DV, kijk dan ook naar de situaties waarin het voor je data warehouse niet de beste keuze is:
- Direct rapporteren: Wil je data vooral direct in een rapportagetool laden om meteen te analyseren, dan past DV mogelijk niet bij wat je nodig hebt. De structuur, met veel joins, kan de prestaties drukken. Voor goede rapportage heeft een DV meestal een tussenliggend dimensioneel model of een aparte rapportagelaag nodig, zodat data sneller op te vragen is.
- Eén bron of statische data: De voordelen van DV worden zichtbaar bij meerdere bronnen en een dynamische dataomgeving. Bestaat je datalandschap uit maar één bronsysteem, of uit statische data die weinig verandert, dan kan de complexiteit van een DV zwaarder wegen dan de voordelen. In zulke gevallen past een eenvoudiger DM vaak beter: de data hoeft dan minder bewerkt te worden en je krijgt een overzichtelijker beeld van de data.
Conclusie
DVM is een flexibele aanpak voor databeheer en daarmee een best practice voor enterprise data warehousing. DVM integreert ruwe data efficiënt en blijft aanpasbaar als de behoeften van de business veranderen. Het gaat goed om met schaalbare data en houdt met de gestructureerde architectuur van hubs, satellites en links een volledig overzicht van de data.
Voor direct rapporteren, of bij één bron of data die niet verandert, is het mogelijk niet de beste keuze. In de dynamische wereld van data mining en datagedreven beslissingen is het voor organisaties die het meeste uit hun data willen halen belangrijk om te weten wanneer DVM past en wanneer een andere aanpak beter is.
Klantcase: Rituals Cosmetics
Dataplatform voor betere toegang tot data en analyse