Groeperen of verwijderen: dubbele productafbeeldingen opsporen met hashing

Bij rommel denken we meestal aan volgepropte laden en kasten in huis. Aan data denk je dan niet zo snel. Maar net als huisraad neemt data ruimte in, en als je er niet naar omkijkt, wordt het net zo'n rommel.
Zorgen dat onze klanten 2023 beginnen met hun zaakjes (in ons geval hun data) op orde, was een speerpunt voor onze lead developer en architect Andrei Vishneuski, vooral bij klanten met veel assets en grote beeldbibliotheken.
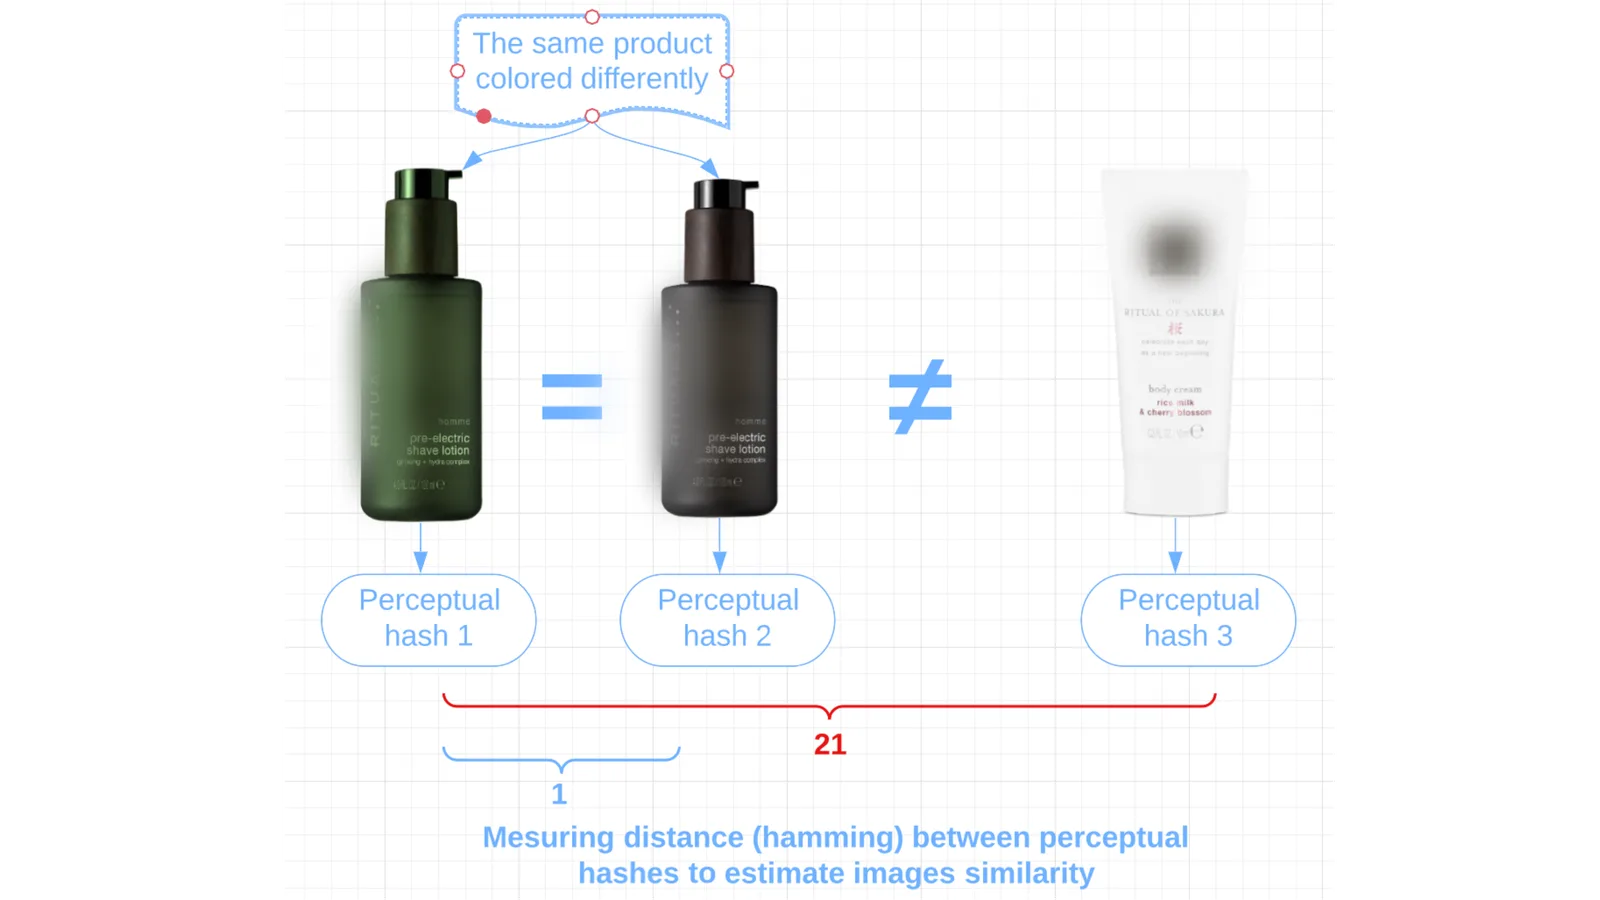
Veel van onze retailklanten merken dat er bij één product honderden afbeeldingen kunnen zijn die niet onder hetzelfde product of dezelfde kenmerken zijn getagd, omdat de afbeelding is bijgesneden, een ander filter heeft, vanuit een andere hoek is genomen of afwijkende kleuren heeft. Terwijl het in werkelijkheid allemaal afbeeldingen van hetzelfde product zijn.
Pak je dat niet aan, dan raakt de beeldbibliotheek vol met dubbele afbeeldingen en assets, en wordt ze rommelig, onoverzichtelijk en moeilijk doorzoekbaar. Om dat op te lossen, onderzoekt Crystalloids "image perceptual hashing".
Andrei vertelt dat hij, toen een toonaangevende luxeretailer klaagde over een groeiend aantal dubbele afbeeldingen in zijn bibliotheek die als "nieuw product" werden gelezen, besefte dat dit op te lossen was met een geavanceerd algoritme in BigQuery.
"Deze retailer moet zijn fotocollectie kunnen ordenen, maar kan op dit moment geen vergelijkbare foto's herkennen anders dan door ze pixel voor pixel te vergelijken," legt Andrei uit. Volgens hem is dat precies waar een oplossing als image perceptual hashing kan werken.
Wat is image perceptual hashing?
Om duidelijk te maken waar een oplossing als image perceptual hashing het best past, gaf Andrei de volgende vergelijking:
"Stel dat je twee foto's hebt van dezelfde persoon, maar ze verschillen allebei een beetje (al staat dezelfde persoon op de foto). De huidige, traditionele methoden die pixel voor pixel vergelijken, zien die afbeeldingen niet als vergelijkbaar," zegt Andrei. Zo ontstaan dubbele beeldassets en onnodige varianten in je bibliotheek.
"Maar als je een perceptueel algoritme op je beeldbestand loslaat, krijg je een score terug voor de afbeeldingen en voor hoe dicht ze bij elkaar liggen. De omstandigheden van de foto kunnen dus verschillen, maar er wordt gekeken naar het eigenlijke onderwerp van de foto, en dat wordt gerangschikt."
In gewone taal: "Net als ons brein. Wij vergelijken afbeeldingen niet pixel voor pixel, maar we zien hoe dicht ze bij elkaar liggen aan de hand van vorm, kleur enzovoort. Met image hashing kun je dus herkennen of foto's op elkaar lijken zonder ze pixel voor pixel te vergelijken," vertelt Andrei.
Volgens Andrei herkent het algoritme voor perceptual image hashing een afbeelding in je bibliotheek ook als die is bijgesneden of in een andere resolutie of een ander formaat is opgeslagen (bijvoorbeeld JPEG, TIFF of PNG), en legt het de relatie. Het kan ook op andere data warehouses draaien, maar image hashing werkt het best op BigQuery.
"Op dit moment draaien we dit algoritme op BigQuery. We nemen een batch of verzameling foto's en sturen die (de meta-informatie) naar het demosysteem (een PubSub). Dat wordt vervolgens opgeslagen, overgezet naar een BigQuery-tabel en gevisualiseerd in Looker Studio," zegt Andrei, die deze oplossing nu invoert voor een vooraanstaande luxeretailer die op het Cloud Platform van Google werkt.
"Zonder BigQuery is een algoritme als dit moeilijker in te voeren. BigQuery kan veel meer data aan dan andere data warehouses, en je kunt er complexere algoritmen op draaien, zoals het algoritme dat voor image perceptual hashing nodig is," aldus Andrei.
Hoe werkt image hashing in de praktijk?
Het is ingewikkeld, maar als onze lead developer kon Andrei de belangrijkste stappen schetsen om een algoritme voor image hashing te draaien en de resultaten te visualiseren.
Op hoofdlijnen verloopt perceptual image hashing in deze stappen:
1: Verzamel de beeldinformatie van de klant via PubSub (minimaal nodig is de url van de afbeelding, het http-adres)
2: Verwerk de beeldinformatie uit PubSub en download die vervolgens naar BigQuery
3: Bereken perceptual hashes met een Cloud Function en sla de beeldinformatie samen met de berekende perceptual hashes op in BigQuery
4: De berekende resultaten worden met een numerieke score ingedeeld in deze categorieën van gelijkenis:
- Getransformeerde afbeeldingen
- Bijgesneden afbeeldingen
- Afbeeldingen met andere kleuren
Een score die zo dicht mogelijk bij nul ligt, betekent dat het algoritme in BigQuery de afbeeldingen als bijna volledig gelijk ziet
5: Visualiseer de uiteindelijke berekeningen en de scores voor gelijkenis in Looker Studio
Heb ik dit nodig? Kan ik dit invoeren?
Image perceptual hashing kan nuttig zijn voor elk datagedreven bedrijf dat met grote hoeveelheden beelddata werkt en een uitgebreide beeldbibliotheek heeft die altijd actueel, geordend en goed gecatalogiseerd moet zijn.
"Met perceptual hashing herken je vergelijkbare afbeeldingen, ook als ze niet helemaal hetzelfde zijn. Denk aan bijgesneden afbeeldingen, of afbeeldingen met andere kleuren of die getransformeerd zijn. Dat kan belangrijk zijn om je beeldcollectie op orde te houden, dubbel bijhouden te voorkomen en verschillende weergaven van één product in je catalogus te hebben," legt Andrei uit.
Gezien de enorme hoeveelheid beelddata die je moet verwerken om image perceptual hashing te draaien, is het aan te raden de data warehouse-mogelijkheden van BigQuery te gebruiken.
"Het hart van deze implementatie, en wat haar uniek maakt, is BigQuery. Perceptual hashing is mogelijk dankzij de opslag en rekenkracht van BigQuery. Daarnaast is visualisatie belangrijk. Om te laten zien hoe dit algoritme werkt, gebruiken we DataStudio. Dat is heel geschikt om te tonen hoe image perceptual hashing dezelfde afbeeldingen verbindt en herkent," aldus Andrei.
Conclusie
Ons team test deze oplossing op dit moment voor invoering bij een retailklant met een omvangrijke webshop. Maar de voordelen van zo'n functie kunnen voor al onze klanten nuttig zijn, uit het verleden, nu en in de toekomst.
Kort gezegd kan de oplossing de volgende cases oplossen:
- De beeldcollectie ordenen en op orde houden door dubbele afbeeldingen en varianten van hetzelfde product in de catalogus te voorkomen
- In theorie kun je deze aanpak gebruiken als aanbevelingsalgoritme. Een koper die een product heeft besteld, kan interesse hebben in producten die erop lijken. Die gelijkenis kun je berekenen op basis van perceptual hashes.
Ons team blijft onderzoeken wat er met image perceptual hashing mogelijk is, ook als aanbevelingsalgoritme, en schrijft daar een vervolgartikel over. Heb je intussen vragen over hoe deze oplossing je interne beeldbibliotheek kan verbeteren, of wil je je beeldbibliotheek voor het nieuwe jaar laten optimaliseren, neem dan gerust contact op.
Alexander Jansen
Alexander is Head of Development bij Crystalloids en werkt als Lead Developer. Hij richt zich op het bouwen van betrouwbare cloudfundamenten en schaalbare oplossingen.
Bekijk alle artikelen