Packaged of headless CDP: welke past het best?
De belangstelling voor packaged Customer Data Platforms (CDP's) en het gebruik ervan zijn de afgelopen jaren flink gegroeid. Maar het landschap verandert, en daardoor twijfelen velen in onze branche aan hun effectiviteit, hun toekomst en hun kosten.
In deze blogreeks bespreken we de belangrijkste punten om op te letten bij de keuze tussen een headless CDP en een traditioneel, packaged CDP.
Wat is een packaged Customer Data Platform (CDP)?
Een packaged Customer Data Platform (CDP) is software waarmee bedrijven klantdata uit verschillende bronnen in de hele organisatie verzamelen, samenbrengen, analyseren en activeren.
Traditionele software voor customer relationship management (CRM) richt zich op het beheren van klantinteracties en verkoopprocessen. Een CDP geeft daarentegen specifiek één beeld van de klant, dat verschillende afdelingen binnen een organisatie kunnen gebruiken, waaronder marketing, sales, klantenservice en productontwikkeling.
Een packaged CDP is kant-en-klare software die snel en eenvoudig kan worden uitgerold en ingericht, vaak met weinig inzet van IT. Zulke oplossingen hebben meestal kant-en-klare koppelingen met veelgebruikte marketing- en advertentieplatforms, en vooraf ingerichte datamodellen en analysedashboards, zodat bedrijven snel aan de slag kunnen.
Leveranciers van packaged CDP's stellen dat hun product de oplossing is, maar gaan eraan voorbij dat er een ecosysteem nodig is om alle use cases voor klantdata te dekken, over verschillende tools en teams verderop in de keten heen.
Dataplatforms (data warehouses) in de publieke cloud bieden dat ecosysteem. De overlap met packaged CDP's groeit, omdat het veel makkelijker is geworden om de functionaliteit van bestaande CDP's te bouwen, of preciezer: samen te stellen.
Wat is een headless Customer Data Platform (CDP)?
Een headless Customer Data Platform (CDP) is een steeds populairdere oplossing die zonder packaged CDP-tool of -suite wordt ingericht, waarbij:
- Een cloud data warehouse, zoals GCP BigQuery, Snowflake en AWS Redshift, het datafundament vormt. Verschillende databronnen worden ingelezen, getransformeerd en samengevoegd.
- Acties en inzichten op alle niveaus worden gemaakt, inclusief klantdata. Denk aan data op product- en campagneniveau.
- Data rechtstreeks vanuit de omgeving van het cloud data warehouse, waar het centrale beeld staat, in kanalen en platforms wordt geactiveerd.
- Een combinatie van cloud-native (data)diensten en gespecialiseerde tools of frameworks wordt gebruikt.
Zoals we bespraken in ons artikel 'De echte CDP-revolutie zit in de publieke cloud', zagen we bij onze klanten de beweging naar de publieke cloud, en deelden we onze waarnemingen en ervaringen.
De headless aanpak: van content naar klantdata
Een headless architectuur werd populair bij contentmanagement (CMS) en wordt daar nu breed gebruikt.
Het CMS fungeert nu als centrale contenthub doordat de back-end (contentbeheer) en de front-end (website) van elkaar zijn losgekoppeld. Via een API kunnen content en acties worden gedeeld met verschillende applicaties, zoals websites, apps of zelfs dynamisch gegenereerde e-mails. De front-end is niet meer verweven met het contentmanagementsysteem. Het resultaat: omdat alle content in één systeem staat, kunnen ontwikkelaars front-end-applicaties los van het CMS bouwen.
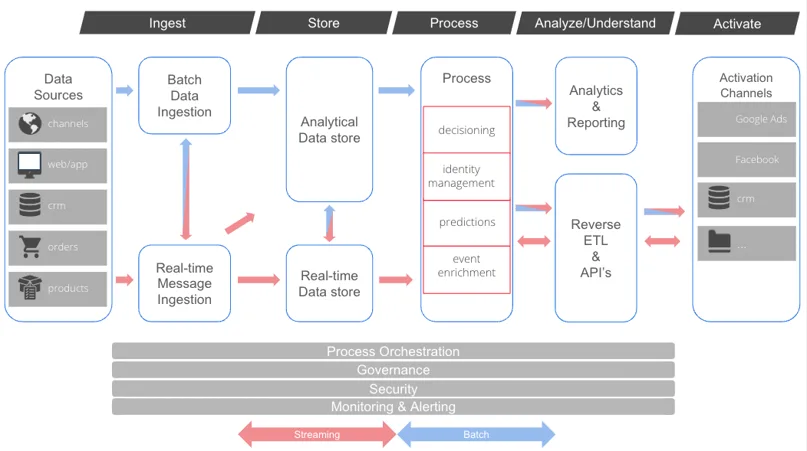
Het headless CDP fungeert als hub voor (marketing)data, beslissingen en activatie, waar inzichten en acties op verschillende niveaus kunnen worden gemaakt. Die worden geactiveerd in of gekoppeld aan kanalen, tools of platforms (denk aan doelgroepen, events of triggers). Dat gebeurt rechtstreeks vanuit het cloud data warehouse, zonder dat er een losse CDP-oplossing nodig is.
Er is echter geen centrale gebruikersinterface. De oplossing bestaat uit een combinatie van diensten binnen de cloudomgeving (bouwstenen) en andere (gespecialiseerde) tools die een specifieke behoefte vervullen (bijvoorbeeld connectiviteit of besluitvorming).
Niet beperkt tot klantdata
We vergelijken de headless aanpak met bestaande packaged CDP-oplossingen, die vooral rond klantdata zijn gebouwd.
Een headless systeem voor datamanagement is echter niet beperkt tot klantdata. Het werkt samen met het enterprise dataplatform.
Enkele voorbeelden:
- Identiteitsbeheer en een identity graph om identificatoren van klanten en de organisatie aan elkaar te koppelen.
- Het opbouwen van een 360-gradenklantbeeld en (klant)doelgroepen.
- Inzicht krijgen in productprestaties en productdata en -feeds verrijken.
- Modellen maken, zoals productaanbevelingen, engagement- en conversiescores, CLTV, modellen voor het voorspellen van klantverloop of verkoopprognoses. Deze modellen kunnen in batch en realtime worden gebruikt. Direct in het platform, zodat de data het platform niet hoeft te verlaten.
- Bedrijfsregels of "triggers" (decisioning) maken voor opvolging/Next-Best Actions.
- Verkoop- en engagementrapportages op basis van meerdere databronnen. Meldingen en alerts op basis van afwijkingen in die rapportages.
De headless aanpak overlapt sterk met het idee achter de moderne datastack, ook wel het composable CDP genoemd. Dat komt vooral doordat je voor elke platformfunctie producten van cloudleveranciers en SaaS-oplossingen van ISV's kunt gebruiken.
Een data warehouse 'met extra's'
Veel organisaties hebben de laatste tijd geïnvesteerd in een data warehouse van een van de bekende cloudaanbieders, zoals AWS, Azure of GCP. Je kunt data uit verschillende bronnen ophalen en samenvoegen.
Vroeger werden data warehouses gevuld met periodieke batches (per dag of per uur), maar moderne cloud data warehouses kunnen standaard realtime data inlezen. Live bestellingen, leveringen en clickstreamdata van websites en apps komen vaker voor in implementaties van cloud data warehouses.
Werken met zo'n cloud data warehouse en alle diensten binnen deze cloudplatforms is veel toegankelijker geworden. Diensten binnen de cloudplatforms kunnen op elkaar worden gestapeld (bouwstenen), waardoor het makkelijker wordt om grote hoeveelheden data te importeren, te transformeren en te analyseren. De kennis die nodig is om met zo'n dataomgeving te werken, zoals SQL, Java of Python, is ook steeds vaker aanwezig binnen organisaties en bij hun leveranciers.
Reverse ETL, het rechtstreeks vanuit het data warehouse activeren van deze data in kanalen en tools, vergroot de overlap met bestaande CDP's, waardoor het een alternatief wordt.
Headless CDP tegenover packaged CDP: de functionaliteit vergeleken
Anders dan headless CDP's specialiseren packaged CDP's zich meestal op verschillende gebieden. Sommige platforms geven voorrang aan activatie, personalisatie en AI, andere richten zich op het genereren van inzichten, identity resolution en een volledig 360-gradenklantbeeld.
Ondanks hun verschillen moeten vrijwel al deze systemen brondata verzamelen en inlezen. Meestal betekent dat extra trackers op de site plaatsen met JavaScript en first-party data uploaden om online data te combineren met order- of CRM-data.
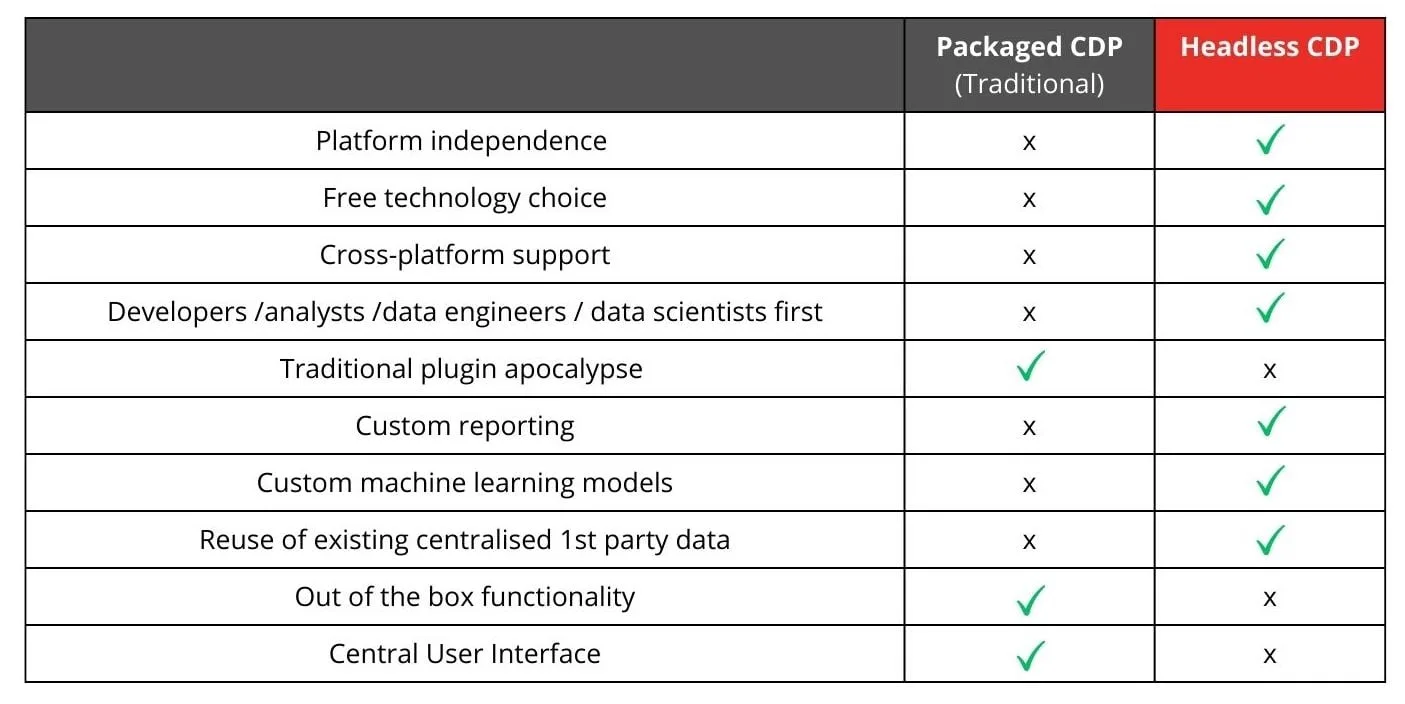
Weeg je een packaged CDP af tegen een headless CDP in een omgeving met een bestaand cloud data warehouse, let dan op het volgende:
- Integratie van databronnen: de databronnen die nu je data warehouse voeden, moeten aan het CDP worden gekoppeld.
- Bestaande systemen: systemen als Google Analytics of Snowplow verzamelen al realtime gedragsdata.
- Mogelijke problemen met packaged CDP's:
- Impact op prestaties: nog een tracker op je website of in je app kan die trager maken.
- Verschillen in metingen: de meetmethode van de nieuwe tracker kan afwijken van die van je bestaande systemen.
- Dubbele bedrijfsregels: het kan zijn dat je bedrijfsregels dupliceert die al in je data warehouse zijn vastgelegd, zoals:
- Identity resolution
- Het opbouwen van een 360-gradenklantbeeld
- Doelgroepselecties
Geldt het bovenstaande voor jouw organisatie, dan is er overlap. De meeste packaged CDP's en tools voor datamanagement moeten zo samenwerken dat ze gebruik kunnen maken van alles wat al in je data warehouse is verzameld en berekend.
Headless CDP: de uitdagingen
Packaged CDP's hebben ook hun voordelen.
Allereerst: heb je (nog) geen data warehouse en zijn de middelen beperkt, dan kan een packaged CDP-suite bij je passen en je snel op weg helpen, gezien de functionaliteit die direct beschikbaar is. De kosten hangen sterk af van het type systeem, het volume en de koppelingen.
Als je inzoomt, heeft het headless CDP de volgende nadelen:
Een headless systeem heeft geen centrale gebruikersinterface, waardoor het lastig is om instellingen eenvoudig aan te passen of inzicht te krijgen in alle processen. Inzicht in de processen van een headless systeem is zeker mogelijk, maar dat inzicht moet je zelf maken of het is verspreid over meerdere systemen.
Zo kan technische of SQL-kennis nodig zijn om doelgroepen of journeys in te richten. Een optie is een low-code-applicatie erbovenop te zetten, zoals Google's Appsheet, of Looker Blocks en Actions te gebruiken.
(Realtime) decision engine of flowbuilder: beslissingen nemen op basis van realtime datastromen (bijvoorbeeld web- of appdata). Zo'n realtime decision engine bouwen (bijvoorbeeld voor online personalisatie) kan in de cloud, maar is complexer dan regels bij elkaar klikken in een gebruikersinterface, omdat het met code gebeurt.
Ook zijn flows of journeys in de meeste CDP-oplossingen eenvoudig te maken. Voor batchorkestratie gebruiken we vaak Cloud Composer van Google. Voor realtime gebruiken we een Cloud Function en PubSub.
Het platform onderhoudt de connectiviteit met kanalen en tools. Bij een headless CDP moet je een deel van de koppelingen zelf bouwen (meestal via API-koppelingen), al zijn er inmiddels verschillende (open-source) frameworks, zoals Google Tentacles, en "reverse ETL"-tools, zoals Looker, Hightouch, Flywheel Software en Census.
De time-to-market is langer, omdat het platform ontworpen en gebouwd moet worden.
Is je organisatie niet complex en heb je eenvoudige use cases, dan kan een packaged CDP een geschikte keuze zijn. Houd er wel rekening mee dat een packaged CDP misschien aan je huidige behoeften voldoet, maar tegen grenzen kan aanlopen naarmate de eisen van je organisatie veranderen en groeien.
Headless CDP: de voordelen
Meer flexibiliteit
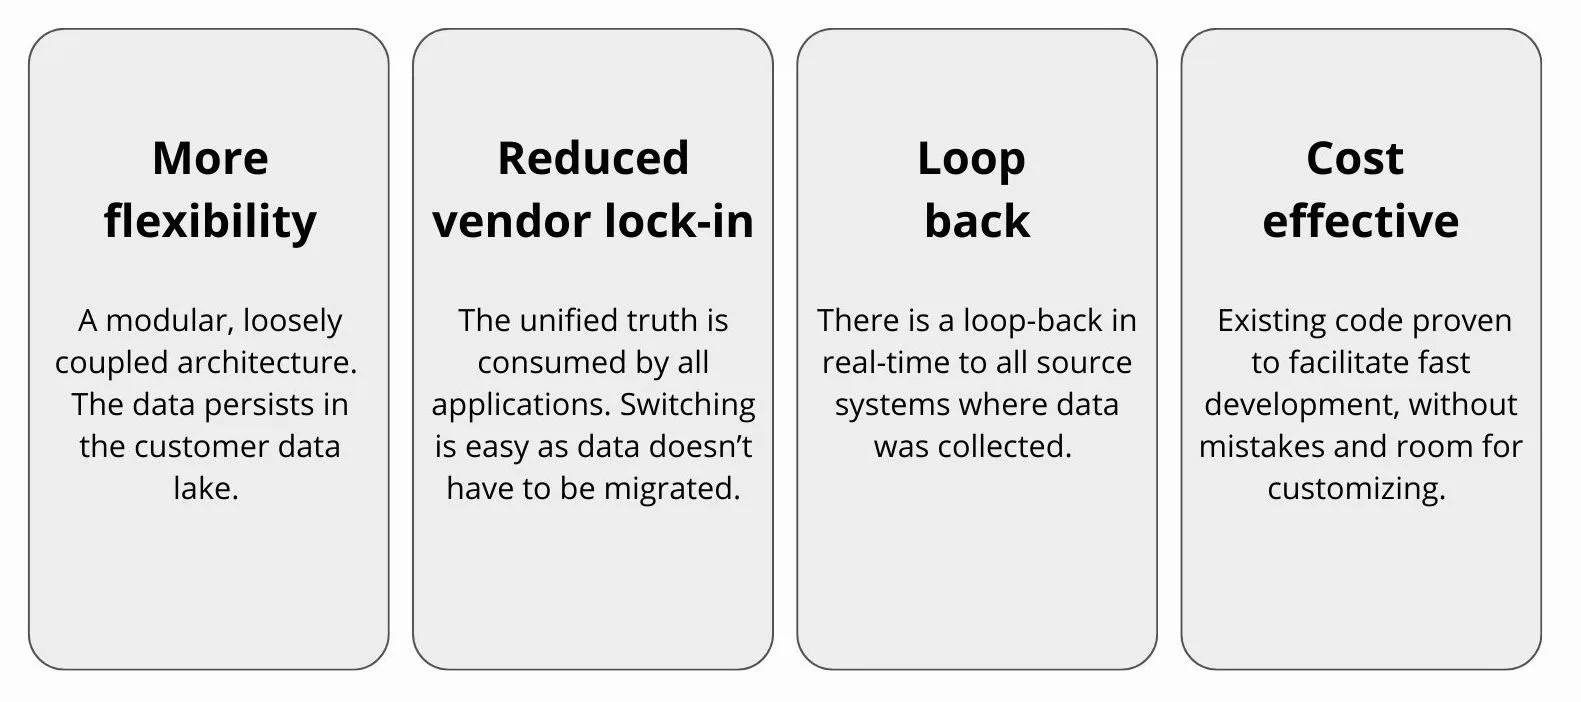
De headless CDP-aanpak geeft de flexibiliteit die nodig is om snel te vernieuwen en een wendbare roadmap te hebben, dankzij een modulaire, losjes gekoppelde architectuur en data die in een realtime cloud data warehouse wordt bewaard.
Minder afhankelijkheid van een leverancier
Anders dan bij kant-en-klare CDP-opties zit de data bij de headless CDP-aanpak niet "opgesloten". De "single source of truth" is beschikbaar voor alle applicaties, wat het risico op vendor lock-in verkleint.
Realtime terugkoppeling
De headless CDP-aanpak maakt ook een eenvoudige, realtime terugkoppeling mogelijk naar bronsystemen die geconsolideerde data uit het CDP nodig hebben.
Kostenefficiëntie
Door cloud-native onderdelen met een pay-as-you-go-prijsmodel is de headless CDP-aanpak kosteneffectief, met lage totale eigendomskosten (TCO).
Reverse ETL: de brug tussen data en actie
Er zijn al veel tools die data in je data warehouse laden. Sinds kort is er een nieuw segment op de markt: reverse ETL. Deze tools kunnen data activeren in je marketingkanalen of andere platforms. Reverse ETL probeert dit probleem op te lossen. Met een reverse-ETL-tool kun je je richten op het bouwen van use cases, zonder je zorgen te maken over het ontwikkelen en onderhouden van connectors (bijvoorbeeld Flywheel Software, Census, Hightouch, Looker Actions, Segment). Daarnaast geven de tools inzicht in het proces en in de data die uit je cloudplatform stroomt.
Een voorbeeldopzet:
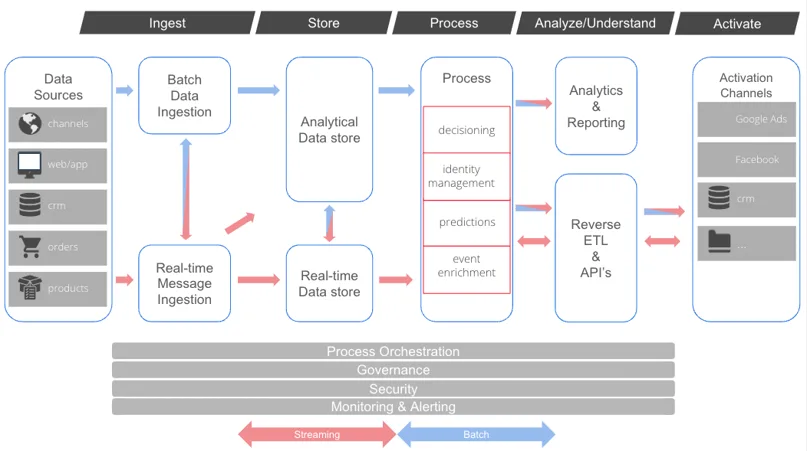
Naast cloud-native tools van Google kun je SaaS-oplossingen van externe ISV's gebruiken voor het inlezen, transformeren, analyseren of beheren van data. Doe je dat, dan krijg je een hybride samengesteld CDP.
Wanneer kies je voor een headless CDP?
Heeft je organisatie al een cloud data warehouse of is ze van plan er een op te zetten, dan is de headless aanpak interessant als je:
- Geen (duur) CDP-tool wilt aanschaffen en implementeren, bijvoorbeeld als je doelgroepen, triggers of andere data rechtstreeks vanuit het data warehouse wilt delen met je (marketing)kanalen of (externe) platforms.
- Geavanceerde en complexere use cases wilt realiseren op basis van verschillende bronnen en combinaties, die in packaged of losse CDP-tools niet of moeilijk te bereiken zijn (door dingen bij elkaar te klikken), of niet zonder de data uit en weer in het CDP-platform te verplaatsen om de nodige acties uit te voeren?
- Geen data wilt dupliceren en bedrijfsregels niet in verschillende omgevingen opnieuw wilt opbouwen (single source of truth).
- Bestaande investeringen in een cloud data warehouse optimaal wilt benutten? Ook als je data lake in een andere cloud dan Google Cloud staat, blijft Google Cloud de meest geschikte optie om je CDP te hosten.
- De mogelijkheden van data die niet over klanten gaat, zoals product- of campagnedata, wilt benutten en die data wilt activeren.
- Als je de afhankelijkheid van leveranciers van systemen en applicaties wilt verkleinen.
- Als de kosten van het packaged CDP vertienvoudigen terwijl je bedrijf verdubbelt. Bij een headless aanpak stijgen de kosten alleen met de extra verwerking en opslag die nodig zijn voor de groei. Tot nu toe zien we dat headless kosteneffectiever is.
- Verschillende clouddiensten en specifieke of gespecialiseerde tools (zoals reverse ETL) maken het relatief eenvoudig om data en tools te koppelen, waardoor je vrij bent in je keuze.
- Stel dat je in de toekomst flexibel wilt zijn in het toevoegen en weer afstoten van specifieke oplossingen, en dat wil je, want niets blijft altijd hetzelfde.
Waarom kan GCP je bestaande data lake buiten Google versterken?
Wat als je bedrijf al een data lake heeft op AWS, Azure of in een andere cloudomgeving? Begrijpelijk dat je je investeringen in die clouds wilt beschermen en ze niet wilt dupliceren.
In zulke gevallen bouwen we geen tweede data lake. We brengen alleen de data die nodig is voor de use cases van marketing en sales naar het CDP op Google Cloud, en koppelen de resultaten terug aan het data lake en andere systemen. Een multicloudstrategie is een trend waarbij bedrijven per use case de beste cloud kiezen.
GCP is goed te koppelen aan allerlei databronnen, zodat je je data snel vanaf één plek kunt samenbrengen en benaderen. Dat kan je waardevolle tijd en middelen besparen die je anders kwijt zou zijn aan het beheren van losse databronnen. Je investeringen in bestaande clouds beschermen is dus belangrijk, maar het is de moeite waard om te kijken wat het koppelen van GCP oplevert om meer uit je data te halen.
Google Cloud is om verschillende redenen sterk gepositioneerd voor een headless CDP:
- de standaardkoppelingen met advertentieplatforms
- de AI-mogelijkheden die goed zijn afgestemd op marketing en advertising
Daarnaast werken we met een serverless platform, wat betekent dat er geen technisch onderhoud nodig is.
Realtime headless CDP in de praktijk bij Crystalloids
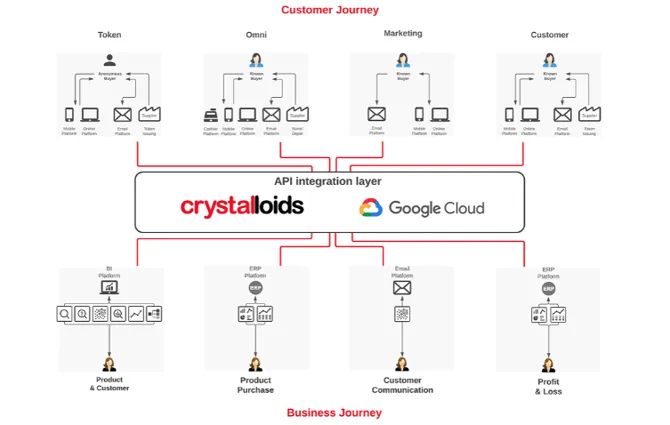
De datastromen en koppelingen die we hebben ontwikkeld, met gebruik van de kosteneffectieve en realtime mogelijkheden van Google Cloud Platform, zijn vooraf gedefinieerde bouwstenen die we op jouw specifieke eisen kunnen afstemmen.
Bij packaged software ben je afhankelijk van de bestaande functionaliteit en de roadmap van de leverancier. Wij bouwen in plaats daarvan een oplossing die altijd aansluit op je huidige en toekomstige behoeften. Daarom geeft ons headless CDP-dataplatform (API-gedreven) meer flexibiliteit om je eigen regels te bepalen voor zaken als user stitching of het opbouwen van doelgroepsegmenten.
Conclusie
Traditionele CDP-oplossingen hebben bedrijven goed geholpen bij het beheren van klantdata, maar headless CDP's zijn een flinke stap vooruit. Headless CDP's bieden meer flexibiliteit, schaalbaarheid en wendbaarheid doordat de gebruikersinterface aan de front-end is losgekoppeld van het databeheer aan de back-end. Daardoor kunnen bedrijven zich snel en efficiënt aanpassen aan veranderende behoeften en marktomstandigheden.
Bij Crystalloids ontwerpen en implementeren we al meer dan acht jaar data-ecosystemen in de publieke cloud, waaronder wat wij een headless Customer Data Platform of Unified Marketing Technology Stack noemen. Nu het begrip "headless" in de branche steeds gangbaarder wordt, is duidelijk dat deze aanpak waardevolle voordelen biedt voor moderne datamanagementstrategieën.
Marc de Haas
Marc is Head of Development bij Crystalloids en werkt als Solution Architect en Cloud Architect nauw mee aan klantprojecten.
Bekijk alle artikelen