Hoe bouw je een klantdatamodel?
Elke organisatie wil datagedreven werken, want data is een krachtig middel voor betere besluitvorming. Maar om dat goed te benutten heb je een doordachte data-infrastructuur nodig, en een klantdatamodel is een van de vijf fundamenten van een moderne datastack. Samen met data-ingestie, visualisatie, intelligente toepassingen en activatie zorgt het modelleren van klantdata ervoor dat analytics in je hele organisatie toegankelijk wordt.
Customer Data Management is een ander belangrijk aspect: het zorgt ervoor dat data goed beheerd en benut wordt, zoals hier uitgelegd.
De fundamenten van een moderne datastack
Een klantdatamodel bouwen is na data-ingestie het tweede fundament. Heb je klantdata binnengehaald, of dat nu uit je data warehouse of lakehouse is, dan is de volgende stap die data een bruikbare vorm te geven voor je teams en systemen. Daarvoor ontwerp je een structuur die besluitvorming op basis van data in verschillende bedrijfsonderdelen ondersteunt. Een stevig architectuurontwerp is essentieel voor succes op de lange termijn, omdat het ervoor zorgt dat de data is geordend in bruikbare entiteiten die passen bij jouw use cases.
Voor een effectief klantdatamodel zijn twee onderdelen essentieel:
- Identity resolution: dezelfde gebruikers herkennen in verschillende databronnen.
- Masterdatamodel: een schoon, samengevoegd beeld van je klanten, verrijkt met feiten en dimensies.
Een goede aanpak is beginnen met stapsgewijze ontwikkeling en snelle iteratie. Leg bedrijfsobjecten vast die groei mogelijk maken, zoals klantprofielen, transacties en events.
Identity resolution
De eerste stap is het opbouwen van de identity graph van klanten en gebruikers in één globale identifier, die alle interacties van klanten met je kanalen en applicaties aan elkaar koppelt (door velen ook "stitching" genoemd).
De drie belangrijkste stappen voor eenvoudige identity resolution met SQL in je data warehouse:
Bepaal de match keys
Hier beslis je welke velden of kolommen je gebruikt om te bepalen welke personen of dochterbedrijven binnen en tussen bronnen dezelfde zijn. Een typisch voorbeeld van match keys kan een e-mailadres plus een achternaam zijn.
Voeg klantrecords samen
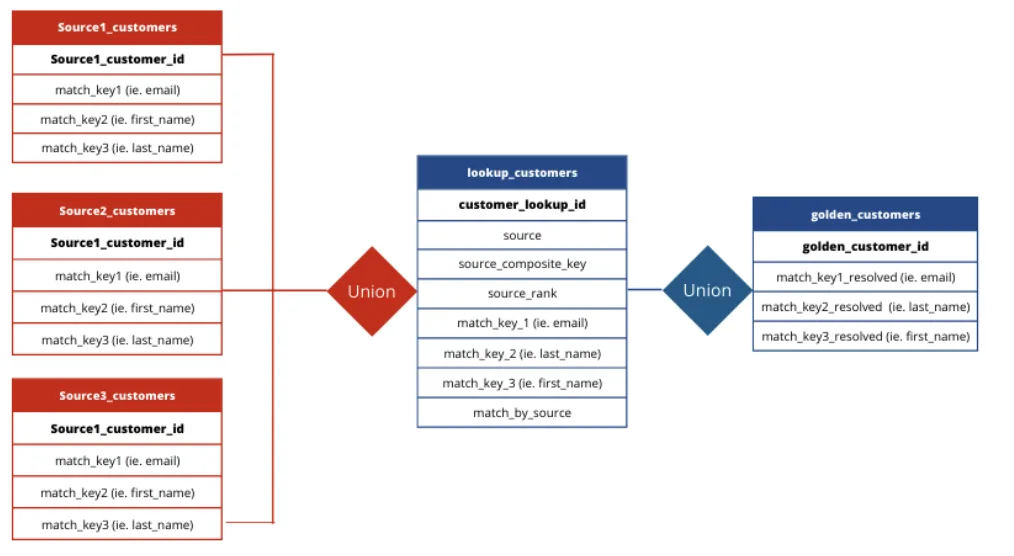
De tweede stap is een opzoektabel maken met alle klantrecords uit je brontabellen.
Match en ken een Global Customer ID toe
De laatste stap is records nemen die dezelfde (of in sommige gevallen vergelijkbare) match keys hebben, en voor die groep overeenkomende klantrecords een unieke klantidentifier genereren op het niveau van je bedrijf. Ik noem dit een Customer ID. Met de gegenereerde Customer ID kun je de klantbronnen voortaan aan elkaar koppelen. Deze blog over een first-party datastrategie beschrijft hoe dat er in de praktijk uitziet.
Voeg je meer bronnen toe, dan kun je die in hetzelfde proces opnemen door de juiste regels en de juiste voorrang voor de bron in te stellen.
Zo kan een ERD van het proces eruitzien in een voorbeeldimplementatie:
Masterdatamodellen bouwen
Met je eerste klantbeeld heb je het eerste identiteitsprobleem opgelost. Daarna moet je je pipelines of ETL-processen inrichten om de mastermodellen te bouwen die je analytics aansturen.
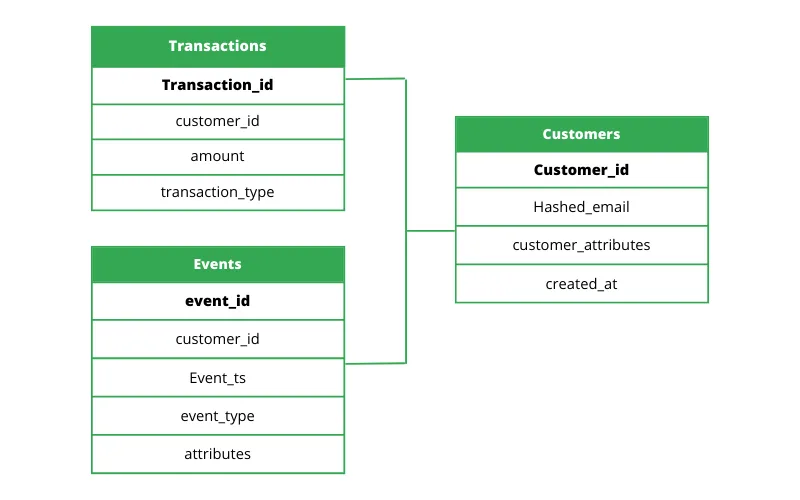
Wil je snel waarde leveren, begin dan met een "Customer→Transaction →event"-framework. Dit framework maakt uit je brondata de drie belangrijkste objecten.
De afbeelding hieronder laat zien hoe dit soort modellering eruitziet.
Customers: tabel met je klanten, waaraan je snel nieuwe velden kunt toevoegen
Transactions: join key uit de klantentabel naar hun transactiegeschiedenis, bijvoorbeeld inclusief productretouren bij een retailer
Events: elk event dat je van elke klant bijhoudt
Is je bedrijf een marktplaats of heeft het verschillende bedrijfsidentiteiten, dan kun je deze masterdatamodellen aanpassen aan wat logisch is. Zo kun je bij een tweezijdige marktplaats tabellen hebben voor zowel verkopers als kopers, als aparte entiteiten. Bij een B2B-bedrijf heb je misschien aparte entiteiten voor accounts en contactpersonen.
Tools voor data-ingestie en transformatie
Er zijn verschillende manieren om data in je data warehouse binnen te halen en te transformeren. Meestal kiezen analyticsteams voor een open-sourceoplossing. In de afgelopen jaren hebben open-sourcetools voor de moderne klantdatastack of CDP het beheren en onderhouden van data eenvoudiger gemaakt, terwijl de kosten flink daalden.
Het meest gebruikt in open source zijn Airflow en Beam. Airflow blinkt uit in data-orkestratie en het beheren van afhankelijkheden tussen pipelines, terwijl Beam een uniforme tool is voor het bouwen van big data-pipelines.
Airflow wordt veel gebruikt voor workflow-orkestratie, om pipelines of machine learning-modellen te draaien. Bij Crystalloids rollen we Airflow en Beam uit met Cloud Composer en Cloud Dataflow.
- Airflow: ideaal voor het beheren van afhankelijkheden tussen pipelines en voor orkestratie.
- Beam: geschikt voor het bouwen van uniforme pipelines voor grootschalige dataverwerking.
Zowel Airflow als Beam kun je uitrollen met managed services als Google Cloud Composer en Cloud Dataflow, of op AWS. Andere alternatieven voor Airflow zijn Prefect, Dagster en Kubeflow.
Staat je gestructureerde data in je data warehouse, dan kun je ook al je transformaties in SQL schrijven. Je vraagt je misschien af hoe je al die transformaties beheert als het er honderden worden. Honderden SQL-query's in een paar mappen opslaan is niet makkelijk te onderhouden.
En als je een van die transformaties wilt bijwerken? Of wilt teruggaan naar een eerdere versie van een van je SQL-scripts? Ben je al in dat stadium, dan wordt DBT (Data Build Tool) je vriend. dbt helpt je al die complexiteit te beheren door een paar werkwijzen in te bouwen, zoals documentatie, lineage van transformaties en modellen (welke transformatie eerst komt), datatests (het is vreemd om transacties met negatieve waarden te hebben) en goed versiebeheer met Git, zodat je alles op één plek hebt en versies kunt volgen.
CI/CD in je pipelines
Heb je je data opgeschoond en getransformeerd, dan is het beheren van wijzigingen cruciaal. We raden een CI/CD-workflow aan, zodat alle aanpassingen aan je modellen goed zijn gecontroleerd voordat ze worden uitgerold.
Je kunt het opgeschoonde model bijvoorbeeld als views in BigQuery opslaan en onder versiebeheer brengen met Cloud Source Repositories of Bitbucket. Van daaruit helpen tools als Google Cloud Build om die wijzigingen door een gecontroleerd OTAP-proces (ontwikkeling, test, acceptatie en productie) te leiden.
Conclusie
Een klantdatamodel is een van de vijf fundamenten van een moderne datastack. Wil je hulp bij het bouwen van de modelleringsonderdelen uit deze blog, dan helpen we je graag.